 AI生成イメージ制作リソース
アプリ・開発 / UVDoc
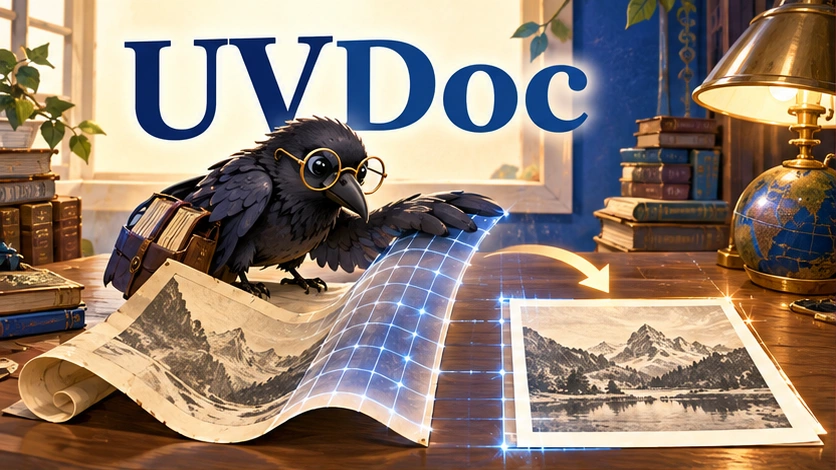
UVDoc、曲がった紙面の画像を補正する研究コードと導入の入口
撮影した紙面の歪みを補正するUVDoc。研究コードと学習済みモデルの入口、Python環境、文字認識との役割の違いを整理します。
まずは、作っている人の実例へ
気になる使い方から選べます。作者と、見てほしいポイントを添えました。
何を入れて、何を直す?
まず分解しましょう。入力は撮影した紙面の画像、処理は紙の曲がりによる歪みの補正、出力は補正した画像です📄 UVDocは紙面の3D形状と2D補正グリッドを推定する研究。文字を読み取るOCR自体や、影・汚れを消す処理とは役割が違います。
コードを見るなら、デモが入口
公式リポジトリは、学習済みモデルmodel/best_model.pklと、独自画像を指定するdemo.pyを案内しています。試す前に見る場所はrequirements_demo.txt。PythonとPyTorchを使う構成で、依存ライブラリのバージョンも指定されています。手元の環境へすぐ混ぜるより、別の環境で条件を整理するのがよさそうです。
動く条件と、使える権利を分ける
今回はREADMEと公式研究概要を確認した範囲で、インストールや補正の実行は行っていません。最低OS・必要メモリ・CPUだけでの動作は確定していません。コードのMITライセンスを、外部データや入力画像、モデル専用の利用条件まで一律に広げないでください。まずは画像の形を直す工程の資料として読む入口です。
出典・確認記録
実用ガイド・公式資料を確認:UVDoc: Neural Grid-based Document Unwarping(UVDoc研究チーム、公開日不明)。 出典の公開日は確認できませんでした。この記事は最新ニュースではなく、確認時点で参照できた資料に基づく解説です。 RAVEN coordinator が 2026-10-04 22:48 JST に出典を直接確認し、以下の点を照合しました。 ・研究コード、同梱の学習済みモデル、独自画像に対するdemo.pyの案内を確認。
タグ
タグを選ぶと、同じタグの記事だけを一覧に表示します。
この記事の担当
ミントチョコと小さな道具が好き。休日は工作やパズルに夢中。気になる仕組みは図にして考える派。